什么是顺序表
顺序表是线性表的一种存储方式。它的底层就是数组——在内存中申请一段连续的空间,依次存放数据元素。
数组本身是静态的(长度固定),而顺序表是在数组外面包了一层,实现了动态管理:可以随时添加元素、删除元素、自动扩容。
顺序表和链表的核心区别:
- 顺序表:内存连续,支持随机访问(
O(1)访问任意位置) - 链表:内存离散,只能顺序访问,但插入删除更灵活
数组
0.1 数组的特点
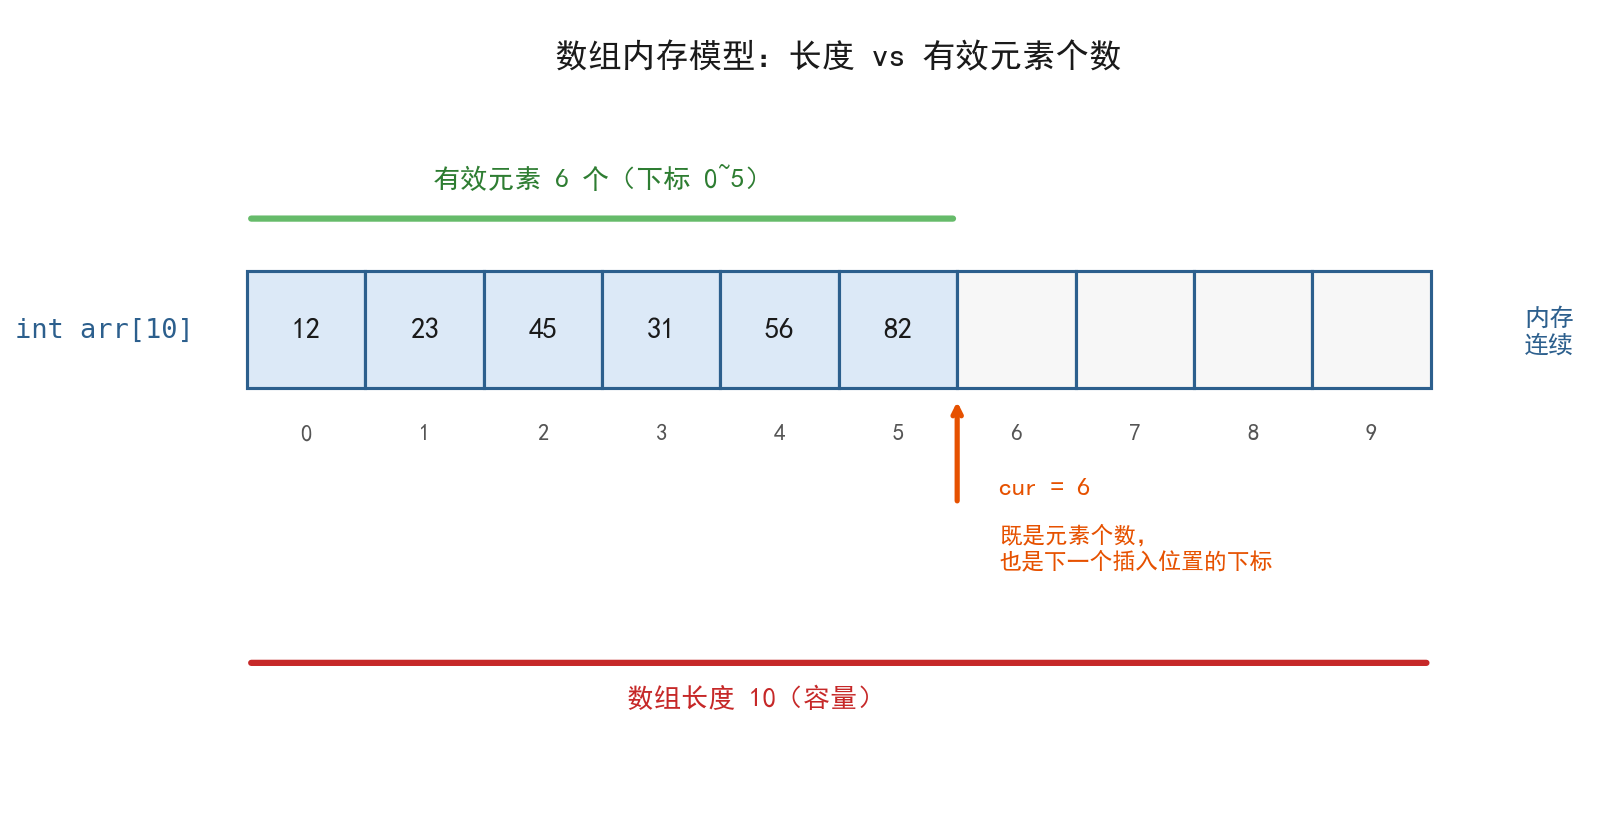
内存是连续的——这是数组最本质的特点,它的所有优点和缺点都从这一条推导出来。
1 | int arr[10]; // 长度 10,下标 0~9 |
- 定义数组时,中括号里必须是常量或常量表达式,C/C++ 不允许用变量定义数组长度
- 数组长度是 10,但下标是从 0 开始的,所以只能访问
arr[0]~arr[9] - 访问
arr[10]就是越界访问
越界访问不一定会让程序崩溃。 有可能程序看起来还在正常运行,但访问到的数据是不是你想要的、算法结果对不对,就完全不确定了。所以绝不要对数组做越界访问。
数组里”长度”和”有效元素个数”是两个不同的概念:
1 | int arr[10] = [ 12 | 23 | 45 | 31 | 56 | 82 | | | | ] |
这个 cur 很关键:它既是有效元素的个数,又刚好是下一个可以插入元素的位置的下标。
0.2 下标访问 ≠ 查找
这两个概念一定要分清楚,很多人描述数组的时候把它们混为一谈。
下标访问(随机访问)——直接用下标拿元素:
1 | arr[0]; // 访问 0 号位 |
因为数组每个元素的内存是连续的,给定下标就能直接算出地址,不需要从头找。所以访问 0 号位和访问 10000 号位,花费的时间一样多。
**下标访问的时间复杂度是 O(1)**——这是常量时间,跟数组多长、访问哪个位置都无关。
查找(搜索)——找出某个值在不在数组里:
1 | for (int i = 0; i < 10; i++) |
这个必须从 0 号位开始一个个比对,数据量越大、找得越慢。
**无序数组的查找时间复杂度是 O(n)**——线性搜索。
对比:
| 操作 | 代码 | 时间复杂度 | 说明 |
|---|---|---|---|
| 下标访问(随机访问) | arr[i] |
O(1) | 直接算地址,与位置无关 |
| 查找(搜索) | 遍历比对 | O(n) | 必须从头找 |
数组的优势是下标访问快,不是查找快。
另外,有序数组可以二分搜索,时间复杂度 O(log n),不需要线性遍历。
0.3 数组的优点
| 优点 | 时间复杂度 |
|---|---|
| 下标访问(随机访问)效率很高 | O(1) |
| 末尾位置增加/删除元素效率很高 | O(1) |
| 访问前后相邻位置的元素非常方便 | / |
- **下标访问 O(1)**:内存连续,直接按地址偏移取值
- **末尾增删 O(1)**:不涉及元素移动。末尾插入就是把值放到
cur位置然后cur++;末尾删除就是cur-- - 访问相邻元素方便:内存连续,指针
++就是下一个元素,指针--就是上一个元素
0.4 数组的缺点
| 缺点 | 时间复杂度 |
|---|---|
| 非末尾位置增加/删除元素效率低下 | O(n) |
| 搜索/查找(无序数组)的效率低下 | O(n) |
| 扩容消耗比较大 | / |
非末尾位置增删为什么是 O(n)?
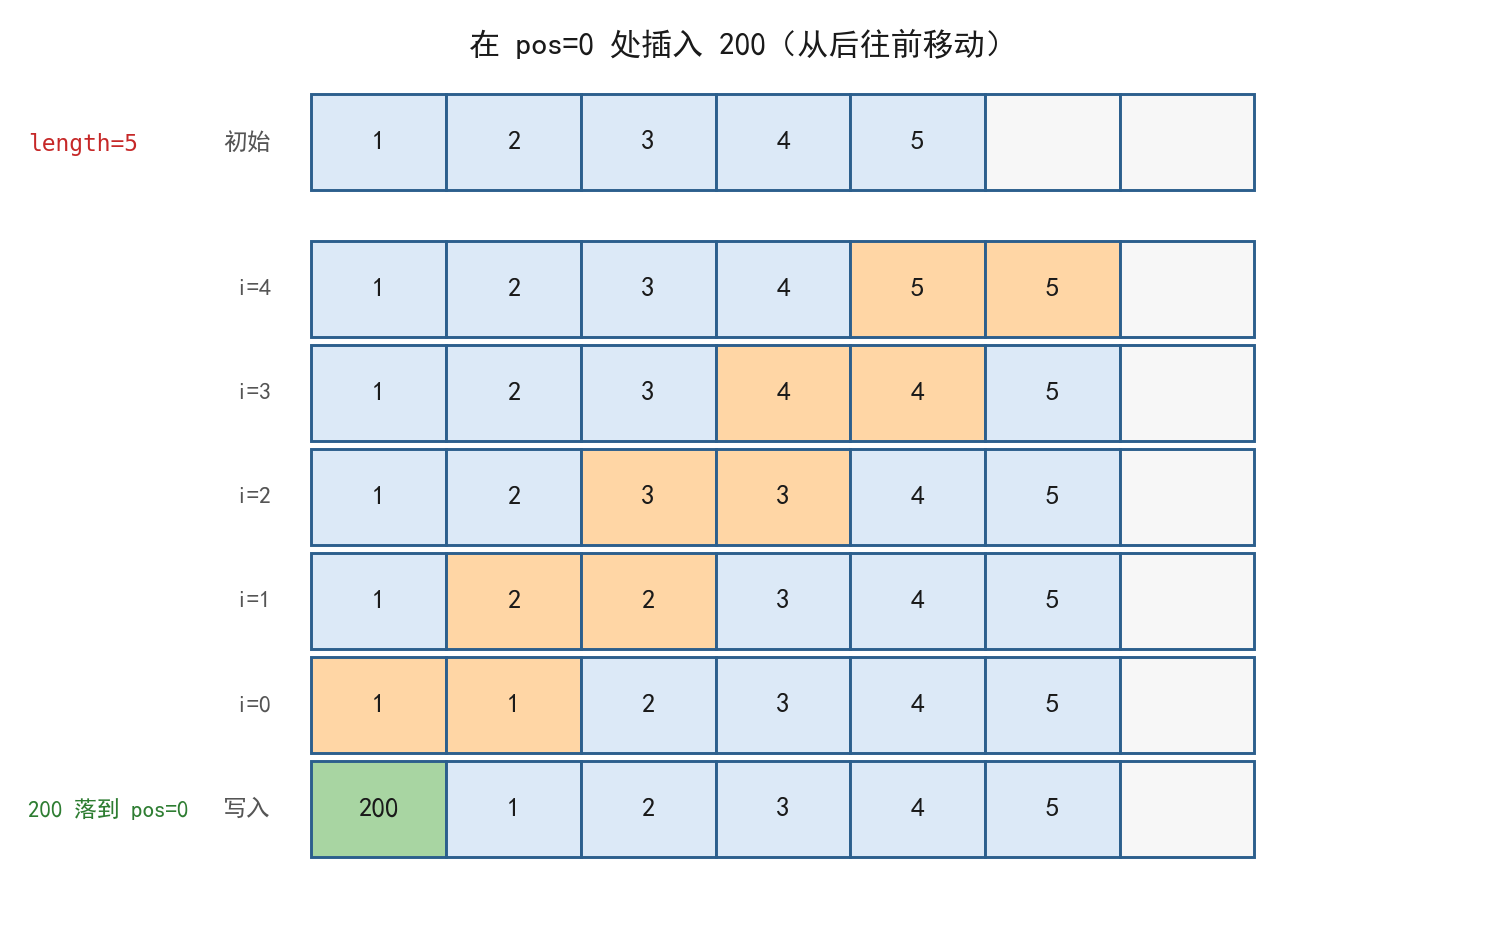
因为内存必须连续,中间要插入一个元素,就得先把后面所有元素依次往后挪一位腾出位置:
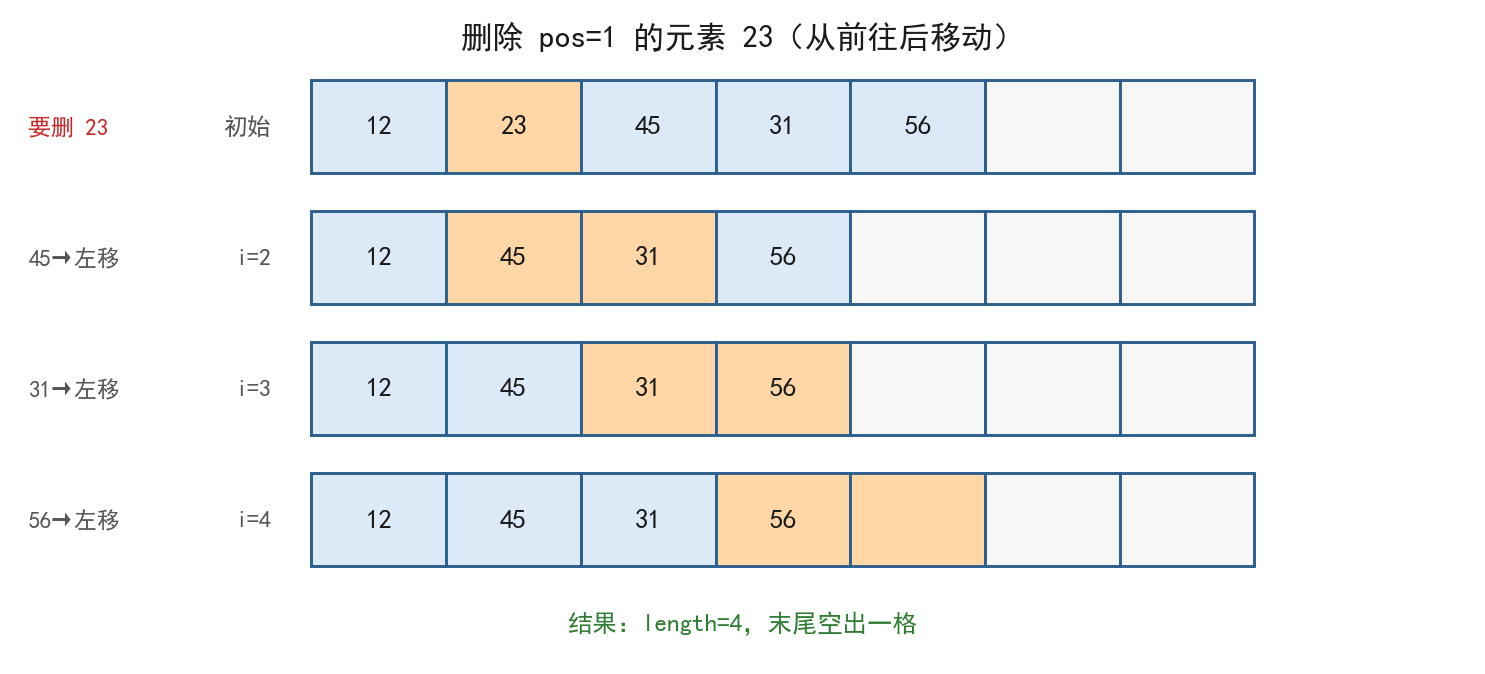
删掉中间的元素也一样,后面的元素要依次往前挪一位把空位填上:
后面元素越多,移动花的时间越多,所以是 **O(n)**。
注意区分:末尾位置增删是 **O(1)**,非末尾位置增删是 **O(n)**。说”数组插入删除效率不高”太笼统了,把这两种情况分开说才是准确的回答。
扩容为什么消耗大?
数组一旦定义,容量就固定了。要扩容只能:
- 在堆上开辟一块更大的新内存
- 把原内存上的数据全部拷贝过去
- 释放原来的内存
数据量越大,拷贝花的时间越多,所以扩容本身是 **O(n)**。
这也是为什么
vector底层虽然是数组,但依然能”动态增长”——满了就扩容。
一、C和C++两种实现对比
| C 版 | C++ 版 | |
|---|---|---|
| 数据和行为 | 分开的(结构体 + 一堆函数) | 封装在一起(类) |
| 内存管理 | malloc / free |
new / delete |
| 传参 | 显式传 SeqList* |
隐含的 this 指针 |
| 访问控制 | 无(全靠约定) | public / private |
| 内部细节 | static 函数(文件内可见) |
private 成员函数 |
二、C 版实现
1 | 01_SeqTable/ |
2.1 结构定义
1 |
|
三个成员变量的关系:
1 | data → [ | | | | | | | ] 堆区的连续空间 |
**重点理解 length**:
- 它既是元素个数,也是下一个元素插入位置的索引
- 所以
data[length]就是当前可以放新元素的那个位置 - 有效元素的下标范围是
[0, length-1]
2.2 函数声明
1 | SeqList* createSeqList(int n); |
关于 static:enlargerSeqList 前面加了 static,意思是只能在本文件内调用。扩容是对外隐藏的实现细节,不需要暴露给用户。这是 C 语言实现封装的一种手段。
2.3 创建与释放
1 | SeqList* createSeqList(int n) |
为什么分两次 malloc?
因为它们是两块独立的内存:
- 表头(
SeqList结构体)存管理信息——指向数据区的指针、长度、容量 - 数据区(
data)才是真正存元素的地方
如果合在一起,扩容的时候就没办法只扩大数据区了。
1 | void releaseSeqList(SeqList* seq) |
释放顺序和创建顺序相反:先释放数据区,再释放表头。每次 free 之后顺手置 NULL,防止野指针。
2.4 尾插法
1 | //尾插法 |
尾插效率最高——**时间复杂度 O(1)**,不需要移动任何元素,直接放在 data[length] 位置即可。
关于 A && B 的短路写法:只有 capacity <= length(真需要扩容)时,才会去调用扩容函数。如果容量够用,短路特性会让 enlargerSeqList 根本不执行。这是竞赛和面试中常见的简洁写法。
2.5 任意位置插入
1 | //任意位置插入 |
位置校验的范围:pos 必须在 [0, length] 之间。
pos < 0不合法pos > length不合法pos == length是合法的——相当于在末尾插入
核心操作:从后往前移动元素
1 | 初始: length=5 |
为什么必须从后往前? 因为写的是 data[i+1] = data[i]。如果从前往后移动,前面的元素会先把后面的覆盖掉,数据就丢了。
**时间复杂度 O(n)**:最坏情况是在头部插入,所有元素都要后移。
2.6 查找
1 | int findSeqList(SeqList* seq,ElemType val) |
非常直观的顺序查找,时间复杂度 O(n)。找到了返回下标,没找到返回 -1。
注意 return -1 的位置:必须在整个循环结束之后再返回 -1。如果写在循环里,第一个元素没匹配上就直接返回 -1 了,后面的元素根本没机会比对。
2.7 删除
1 | int deleteSeqList(SeqList* seq,ElemType val) |
这里用的是按值删除——先调用 findSeqList 找到位置,再删除。查找和删除分开,是更常见的做法。
核心操作:从前往后移动元素
插入是从后往前,删除是从前往后——因为这里写的是 data[i] = data[i+1],用后面的元素覆盖前面的。
**时间复杂度 O(n)**:最坏情况是删除头部元素,后面所有元素都要前移。
2.8 扩容
1 | static int enlargerSeqList(SeqList* seq) |
扩容四步:申请新空间 → 拷贝数据 → 释放旧空间 → 更新指针和容量。
sizeof 里的类型要注意:这里必须写 sizeof(ElemType),不能写成 sizeof(ElemType*)。写错了(比如 ElemType 是 int 时写成了指针大小)会多申请一倍内存——程序不一定崩,但内存就白白浪费了。
2.9 测试代码
1 |
|
2.10 C 版小结
| 操作 | 时间复杂度 | 关键要点 |
|---|---|---|
| 创建 | O(1) | 分两次 malloc:表头 + 数据区 |
| 尾插 | O(1) | 直接放 data[length] |
| 任意位置插入 | O(n) | 从后往前移动元素 |
| 删除 | O(n) | 从前往后移动元素 |
| 查找 | O(n) | 顺序遍历,找不到返回 -1 |
| 扩容 | O(n) | 2 倍扩容 + 拷贝数据 |
三、C++ 版实现
换成 C++ 之后,顺序表变成一个类:数据(成员变量)和行为(成员函数)封装在一起。
文件划分(三个文件):
1 | 01_Array/ |
3.1 类的声明
1 |
|
和 C 版对比:
| C 版 | C++ 版 |
|---|---|
typedef struct {...} SeqList; |
class Array {...}; |
SeqList* seq 显式传参 |
隐含的 this 指针 |
static int enlargerSeqList(...) |
private: void expand(...) |
| 函数散落在头文件里 | 按 public / private 分区 |
**#pragma once**:告诉编译器这个头文件只被包含一次,作用相当于 C 版的 #ifndef / #define / #endif,但写起来更简洁。
三个成员变量和 C 版一一对应:
| C 版 | C++ 版 | 含义 |
|---|---|---|
data |
mpArr |
指向堆区数组内存 |
capacity |
mCap |
数组容量 |
length |
mCur |
有效元素个数 |
m前缀是 member 的意思,表示这是成员变量——这是 C++ 里常见的命名习惯,方便和局部变量区分。
3.2 构造函数与析构函数
1 | // 构造函数:开辟堆内存,初始化成员变量 |
和 C 版的对应关系:
| C 版 | C++ 版 |
|---|---|
createSeqList(n) |
Array(int size = 10) 构造函数 |
releaseSeqList(seq) |
~Array() 析构函数 |
malloc(sizeof(SeqList)) + malloc(...) |
对象本身由编译器管理,只需 new int[mCap] |
free(seq->data) + free(seq) |
只需 delete[] mpArr |
构造函数初始化列表:Array::Array(int size) : mCur(0), mCap(size)——冒号后面这一串就是初始化列表,在进入函数体之前就把成员变量初始化好。
为什么数组不用初始化? new int[mCap]() 后面加小括号会把每个元素初始化为 0。其实不加也行——因为访问数组是通过 mCur 控制的,mCur 是 0 就表示没有有效元素,根本不会去访问。
默认参数:int size = 10 表示用户不传参时默认容量是 10,这样 Array arr; 和 Array arr(20); 都能用。
析构函数里为什么置 nullptr? delete[] mpArr 只是把指针指向的堆内存释放了,指针本身还存着那个已经失效的地址——这就是野指针。置空可以防止后续误用。
顺带说明:对空指针做
delete是安全的(相当于空操作),所以没必要写if (mpArr != nullptr)再 delete。真正要由开发者保证的是:这个指针确实指向一块有效的堆内存。
3.3 末尾增删
1 | // 末尾增加元素 |
1 | // 末尾删除元素 |
mpArr[mCur++] = val; 这一行做了两件事:先把 val 写到 mCur 位置,然后 mCur 自增 1。因为 mCur 既是元素个数、又是末尾元素的后继位置,所以直接写在它那个位置就对了。
末尾删除为什么这么简单? 因为只需要 mCur--。被”删除”的那个元素的值还在内存里,但 mCur 变小了,访问范围就缩小了,那个位置再也访问不到——相当于删掉了。不需要真的把值清零。
**扩容判断用 == 而不是 <=**:因为 mCur 每次最多加 1,不会跳过 mCap。
3.4 按位置插入
1 | // 按位置增加元素 |
逻辑和 C 版完全一致:**校验位置 → 扩容检查 → 从后往前挪元素 → 写入 → mCur++**。
移动方向和原因也和 C 版一样——必须从后往前,否则前面的元素会覆盖后面的。
3.5 按位置删除
1 | // 按位置删除元素 |
删除和插入的校验范围不一样,这点容易记错:
| 操作 | 合法范围 | 原因 |
|---|---|---|
insert(pos, val) |
0 <= pos <= mCur |
pos == mCur 相当于末尾插入,合法 |
erase(pos) |
0 <= pos < mCur |
pos == mCur 是末尾元素的后继位置,那里没有元素,不能删 |
为什么用按位置删除,而不是按值删除?
先 find 拿到下标,再按位置删——两个接口配合起来更灵活,也更通用。
这和 C 版的 deleteSeqList(内部调 findSeqList 再删)是同一个思路,只是 C++ 版把这一步拆开交给了调用者。
3.6 查找
1 | // 元素查询(线性搜索) |
和 C 版的 findSeqList 逻辑完全一样:遍历比对,找到了返回下标,循环结束还没找到返回 -1。
3.7 打印
1 | // 打印数组 |
const 修饰:写在函数后面表示这是一个常成员函数,它不会修改对象的任何成员变量。这是 C++ 的约束——如果 show 里不小心写了修改成员变量的代码,编译器会直接报错。
3.8 扩容
1 | // 内部数组扩容接口 |
和 C 版 enlargerSeqList 是同样的四步:开辟新内存 → 拷贝数据 → 释放旧内存 → 更新指针和容量。
注意:
memcpy是按字节拷贝的,所以数组里存的必须是简单类型(比如int)。如果存的是对象(有指针成员、需要深拷贝),就不能用memcpy,必须逐个赋值
扩容倍数由调用者决定:expand(2 * mCap)。把倍数写在调用处而不是写死在 expand 里面,以后想改成 1.5 倍扩容只需要改调用处。
3.9 测试代码
1 |
|
用随机数填 10 个元素(触发扩容,因为默认容量就是 10),然后依次测试 pop_back / insert / find / erase。
3.10 C++ 版小结
| 操作 | 时间复杂度 | 关键要点 |
|---|---|---|
| 构造 | O(1) | 初始化列表 + new int[mCap]() |
| 析构 | O(1) | delete[] + 置 nullptr |
push_back |
O(1) | 满了先 expand |
insert |
O(n) | 合法范围 [0, mCur],从后往前移动 |
erase |
O(n) | 合法范围 [0, mCur),从前往后移动 |
find |
O(n) | 顺序遍历 |
expand |
O(n) | memcpy 拷贝 + delete[] 旧内存 |
四、C 与 C++ 对照总结
| 对比项 | C 版 | C++ 版 |
|---|---|---|
| 数据组织 | typedef struct |
class |
| 数据与行为 | 分离:结构体 + 全局函数 | 封装:成员变量 + 成员函数 |
| 内存申请 | malloc |
new |
| 内存释放 | free |
delete[] / delete |
| 生命周期 | 手动调 create / release |
构造/析构函数自动调用 |
| 传参 | 显式传 SeqList* seq |
隐含 this 指针 |
| 访问控制 | 无,靠 static 约定 |
public / private |
| 编译期检查 | 无 | const 成员函数等 |
| 实现文件 | SeqTable.h + SeqTable.c + main.c |
Array.h + Array.cpp + main.cpp |
核心操作完全一致:
- 三个成员变量含义相同(指针 / 容量 / 元素个数)
- 插入必须从后往前移动元素
- 删除必须从前往后移动元素
- 扩容都是四步:开辟 → 拷贝 → 释放 → 更新
C++ 多出来的东西:封装、访问控制、自动生命周期管理——这些让代码更安全,但底层的数据结构和算法一点没变。
五、复习要点总结
| 操作 | 时间复杂度 | 关键要点 |
|---|---|---|
| 创建 | O(1) | 表头 + 数据区分两次申请 |
| 尾插 | O(1) | 直接放 data[length] |
| 任意位置插入 | O(n) | 从后往前移动元素 |
| 删除 | O(n) | 从前往后移动元素 |
| 查找 | O(n) | 顺序遍历,循环外返回 -1 |
| 扩容 | O(n) | 2 倍扩容 + 拷贝数据 |
几个细节:
- 下标访问和查找有什么区别? — 下标访问是 O(1)(直接算地址),查找是 O(n)(遍历比对),两个概念不能混为一谈
- 为什么长度和容量要分开记录? — 容量是总空间,长度是已用空间,扩容时靠容量判断
- 插入时为什么 pos 可以等于 length? — 等于 length 就相当于尾插
- 删除后需不需要缩容? — 一般不需要,这就是”以空间换时间”的思想
- 为什么插入从后往前、删除从前往后? — 都是为了不覆盖还没处理的数据